Agent 开发中,大模型本身通常只能处理输入、进行推理并生成结果。
而要处理实际业务,仅靠模型的能力并不能完成任务。
假设我们正在开发一个客户支持 Agent,用户给它一个任务:
帮我整理今天收到的客户问题,结合订单状态和产品知识库,找出最需要优先处理的三个问题,给出处理建议,并为负责人创建跟进任务。
这句话看起来很简单,背后却涉及几个完全不同的系统。
Agent 要先从客服系统读取今天的工单,再根据工单中的订单号查询订单状态;遇到退款、付款或者产品使用问题,还需要读取内部知识库;完成判断以后,可能还要在任务系统中创建跟进任务。
整个过程大致是:
 放大查看 ↗
这些系统通常都有自己的 API、SDK、认证方式和数据格式。
如果我们开发这样一个 Agent,就需要分别编写客服系统、订单系统、知识库和任务系统的集成代码。
以后又开发一个新的 Agent,这些能力可能还要重新接一次。
MCP 解决的正是这一层连接问题。
一、MCP 是什么
MCP 全称 Model Context Protocol,模型上下文协议。
它是一套开放协议,用于让 AI 应用以统一方式连接外部的数据和能力。
一个系统按照 MCP 暴露自己的能力之后,支持 MCP 的 AI 应用就能够发现并使用这些能力。
例如前面的客户支持系统,可以提供:
search_tickets()
get_order()
create_followup_task()
知识库则可以提供:
kb://policies/refund
kb://products/payment
Agent 不需要理解底层客服系统使用的是 REST API,订单系统连接的是 PostgreSQL,还是知识库来自某个内部搜索服务。
这些细节留在 MCP Server 内部。
从 Agent 一侧看到的是统一的 MCP 接口。
因此,MCP 更接近 AI 应用和外部系统之间的一层标准连接协议。
它没有让原来的 API、数据库或者 SDK 消失。
实际项目通常会变成:
AI Application
│
│ MCP
▼
MCP Server
│
├── REST API
├── Database
├── SDK
└── Internal Service
MCP Server 负责把已有系统的能力转换成 AI 应用更容易发现和使用的形式。
这也是理解 MCP 最重要的一点。
二、为什么需要 MCP
假设没有 MCP。
我们的客户支持 Agent 需要查询订单,于是直接在代码里调用订单 API:
def get_order(order_id: str):
return requests.get(
f"https://order.example.com/orders/{order_id}"
).json()
需要读取客服工单,再写一个接口。
需要创建跟进任务,再接一个任务管理 API。
最终 Agent 内部可能出现大量这样的适配代码:
Customer Support Agent
├── Support API Adapter
├── Order API Adapter
├── Knowledge Base Adapter
└── Task API Adapter
对于一个应用,这种方式完全可行。
问题出现在能力开始复用以后。
例如公司后来又有:
客户支持 Agent
销售 Agent
运营 Agent
内部知识助手
桌面 AI 客户端
IDE Agent
它们都可能需要读取订单或者访问知识库。
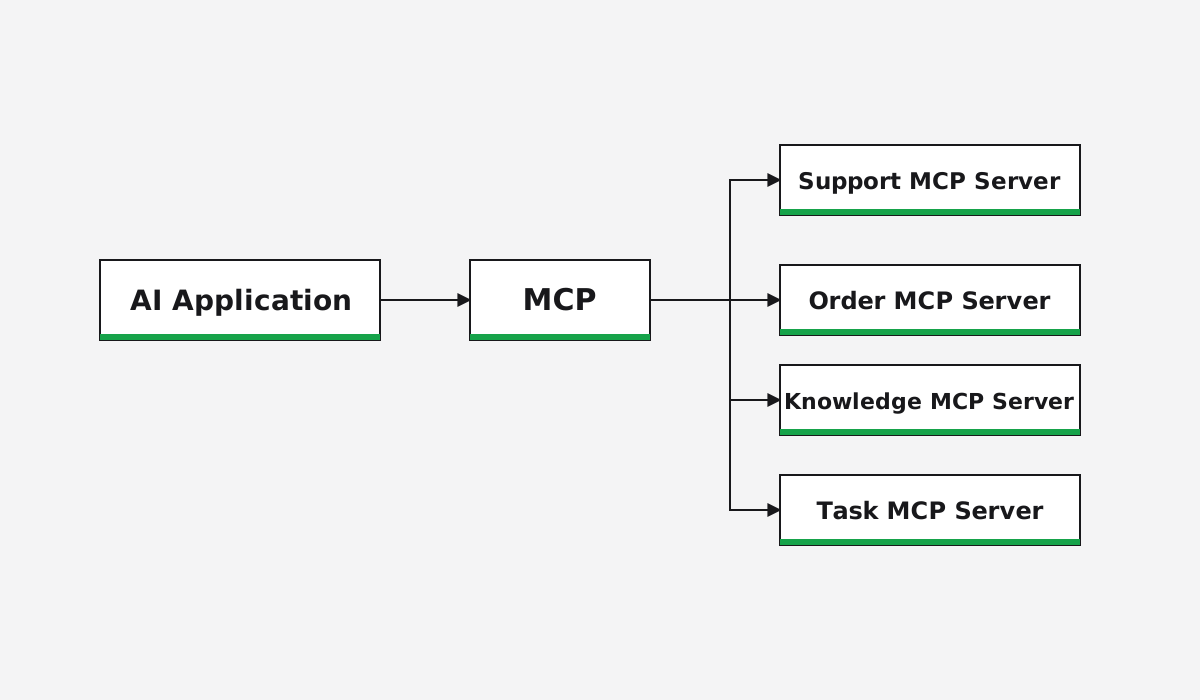
如果每个 AI 应用都自行实现一次集成,系统之间的连接会逐渐成为一张复杂的网。
MCP 希望把这种关系变成:
 放大查看 ↗
外部能力拥有相对统一的协议边界。
AI 应用重点处理模型、上下文和任务执行,MCP Server 负责具体系统的访问方式。
三、MCP 中的 Host、Client 和 Server
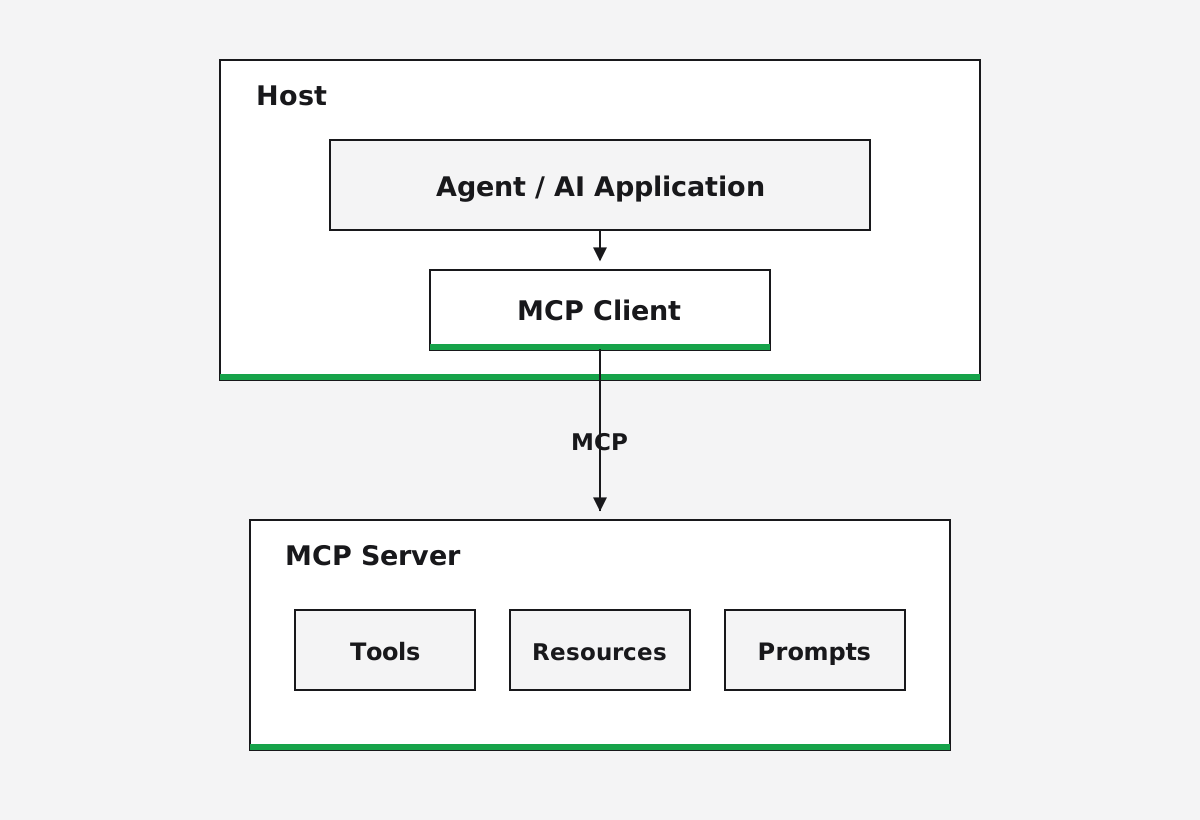
理解 MCP,需要先认识三个角色:
 放大查看 ↗
Host
Host 是承载 AI 能力的应用。
例如一个 Agent 应用、桌面 AI 客户端、IDE,或者我们自己开发的 AI 系统。
Host 通常负责管理模型调用、用户交互、上下文、权限以及 MCP 连接。
Client
MCP Client 是 Host 中负责 MCP 通信的组件。
它知道如何向 Server 查询能力、读取 Resource、调用 Tool,并把结果交回 Host。
因此,MCP Client 和大模型是两个不同的角色。
模型负责判断和推理,Client 负责协议通信。
Server
MCP Server 对外提供具体能力。
例如:
Order MCP Server
Support MCP Server
Database MCP Server
Filesystem MCP Server
Server 可以运行在用户电脑上,也可以部署成远程服务。
目前 MCP 官方提供了 Python SDK,可以直接用来开发 MCP Client 和 MCP Server,并支持 stdio、Streamable HTTP 等标准传输方式。
真正决定 MCP Server 能提供什么的,是接下来三个核心概念。
四、Tools、Resources 和 Prompts
MCP Server 最基础的三类能力是:
Tools
Resources
Prompts
它们经常一起出现,但解决的问题并不相同。
官方对三者的控制方式也有明确区分:Tools 偏向模型选择,Resources 由应用读取,Prompts 通常由用户主动选择。
Tool:让 Agent 执行操作
回到客户支持 Agent。
如果它需要查询工单,MCP Server 可以提供:
search_tickets()
查询订单:
get_order()
创建任务:
create_followup_task()
这些都属于 Tool。
Tool 可以理解为:模型能够选择并调用的函数。
例如:
@mcp.tool()
def get_order(order_id: str) -> dict:
"""Get order information by order ID."""
...
MCP Client 能够发现这个 Tool 的名称、说明以及参数结构。
模型随后就有机会判断:
当前任务需要知道订单状态,因此应该调用
get_order。
在 MCP SDK 中,函数名会成为 Tool 名称,docstring 可以作为描述,而 Python 类型标注会用于生成输入 JSON Schema。
因此:
def get_order(order_id: str)
不仅是普通的 Python 函数签名。
它最终还会帮助 Client 和模型知道:
工具名称:get_order
参数:
order_id: string
Tool 是 MCP 中使用频率最高的能力。
很多 Agent 接入 MCP,首先使用的也是 Tools。
五、Resource:给 AI 应用提供上下文
假设 Agent 正在处理一个退款问题。
除了订单状态,它还需要知道公司的退款规则。
我们当然也可以设计一个 Tool:
get_refund_policy()
不过退款政策本身更接近一份可读取的数据。
MCP 为这种场景提供了 Resource。
例如:
kb://policies/refund
它表示知识库中的退款政策。
还可以定义:
kb://products/{product_id}/manual
表示某个产品的使用说明。
Resource 的核心特征是拥有一个 URI。
应用根据 URI 读取内容,然后将内容加入模型上下文。
官方 SDK 对 Resource 的定义也很直接:Tool 由模型决定调用,而 Resource 是应用选择加载的数据。
因此这两个操作虽然都可能返回数据,语义并不一样:
get_order("A10248")
表达的是:
执行一次订单查询。
而:
kb://policies/refund
表达的是:
这里有一份可以读取的退款政策资源。
六、Prompt:提供可复用的交互模板
第三类能力是 Prompt。
假设客户支持团队有一套固定的问题分析方法:
判断问题类别
判断紧急程度
检查相关订单
确认适用规则
给出处理建议
指出仍需人工确认的信息
可以把这套方法定义为:
analyze_customer_issue
MCP Server 将它作为 Prompt 提供。
用户或者 Host 可以选择这个 Prompt,再传入当前客户问题。
Prompt 更像服务端提供的一套可复用工作模板。
因此三者的职责可以归纳为:
Tool → 做什么
Resource → 读取什么
Prompt → 按什么模板处理
很多 MCP 系统实际上只需要 Tools。
Resources 和 Prompts 并不是为了凑齐 MCP 的三个概念而必须使用。只有当系统确实存在清晰的数据资源或者可复用交互模板时,引入它们才有意义。
七、一次 MCP Tool 调用到底发生了什么
理解 MCP 最容易混乱的地方,是“谁在调用谁”。
假设用户告诉 Agent:
找出今天最需要优先处理的三个客户问题。
一个简化后的执行过程可能是:
User
│
▼
Host
│
│ 获取 Server 能力
▼
MCP Client
│
│ tools/list
▼
MCP Server
│
│ 返回 Tool 定义
▼
Host
│
▼
LLM
│
│ 判断需要 search_tickets
▼
Host
│
▼
MCP Client
│
│ tools/call
▼
MCP Server
│
▼
客服系统
│
│ 返回工单
▼
MCP Server
│
▼
Host / LLM
模型拿到工单后,可能发现其中一个问题涉及订单:
“付款成功,但订单一直显示未支付。”
模型再次判断需要调用:
get_order(order_id="A10251")
订单信息返回以后,模型继续分析。
如果问题涉及退款规则,Host 还可以读取:
kb://policies/refund
最终模型得到足够的信息,再给出处理建议。
如果需要人工跟进,模型可能继续请求:
create_followup_task(...)
整个 Agent Loop 就是这样逐步向前推进。
MCP 处在其中负责外部能力发现与通信的位置。
八、实现一个 MCP Server
理解概念以后,可以写一个最小但具有实际意义的 MCP Server。
本文使用当前官方 Python SDK v2。
安装:
pip install "mcp[cli]"
创建:
server.py
代码如下:
from mcp.server import MCPServer
mcp = MCPServer("Customer Support")
TICKETS = [
{
"id": "T-1024",
"title": "退款五天后仍未到账",
"order_id": "A10248",
"status": "open",
},
{
"id": "T-1025",
"title": "付款成功但订单仍显示未支付",
"order_id": "A10251",
"status": "open",
},
]
ORDERS = {
"A10248": {
"id": "A10248",
"status": "refunded",
"refund_status": "processing",
},
"A10251": {
"id": "A10251",
"status": "payment_review",
"refund_status": None,
},
}
@mcp.tool()
def search_tickets(status: str = "open") -> list[dict]:
"""Search customer support tickets by status."""
return [
ticket
for ticket in TICKETS
if ticket["status"] == status
]
@mcp.tool()
def get_order(order_id: str) -> dict:
"""Get order information by order ID."""
return ORDERS.get(
order_id,
{"error": "Order not found"},
)
@mcp.tool()
def create_followup_task(
ticket_id: str,
title: str,
priority: str,
) -> dict:
"""Create a follow-up task for a support ticket."""
return {
"success": True,
"ticket_id": ticket_id,
"title": title,
"priority": priority,
}
@mcp.resource("kb://policies/{topic}")
def get_policy(topic: str) -> str:
"""Read a customer support policy."""
policies = {
"refund": (
"退款通常会在 3-5 个工作日内到账。"
"超过该时间仍未到账,需要进入人工审核。"
),
"payment": (
"付款成功但订单状态未更新时,"
"应先检查支付回调和订单同步状态。"
),
}
return policies.get(topic, "Policy not found.")
@mcp.prompt()
def analyze_customer_issue(
issue: str,
order_status: str,
) -> str:
"""Generate a prompt for customer issue analysis."""
return f"""
分析下面的客户问题。
客户问题:
{issue}
订单状态:
{order_status}
请完成:
1. 判断问题类别
2. 判断紧急程度
3. 分析可能原因
4. 给出处理建议
5. 指出需要人工确认的信息
"""
if __name__ == "__main__":
mcp.run(
transport="streamable-http",
json_response=True,
)
这个例子虽然很短,实际上已经包含了 MCP Server 的三个核心能力。
search_tickets、get_order 和 create_followup_task 是 Tools。
kb://policies/{topic} 是 Resource Template。
analyze_customer_issue 是 Prompt。
SDK 会根据 Python 函数签名生成工具 Schema,因此我们没有手工编写 JSON Schema,也没有自己实现 tools/list、tools/call 或 resources/read 等协议处理逻辑。
这也是使用 MCP SDK 的主要意义之一。
九、使用 MCP Server
安装 mcp[cli] 后,可以使用开发工具启动:
mcp dev server.py
MCP Inspector 可以帮助我们查看 Server 暴露出来的 Tool、Resource 和 Prompt,并直接进行调用测试。
例如调用:
search_tickets
参数:
{
"status": "open"
}
Server 会返回当前开放工单。
调用:
get_order
参数:
{
"order_id": "A10248"
}
则会得到对应订单状态。
在真正的项目中,只需要把示例里的内存数据替换成真实业务系统:
search_tickets()
│
▼
Customer Support API
get_order()
│
▼
Order Service
create_followup_task()
│
▼
Task System
kb://policies/*
│
▼
Knowledge Base
MCP Server 对 Agent 暴露的接口基本可以保持稳定。
底层实现则可以独立变化。
十、MCP 和 Function Calling 有什么区别
这是理解 MCP 时最常见的疑问之一。
因为看到:
@mcp.tool()
def get_order(...):
...
很容易觉得:
这不就是 Function Calling 吗?
二者确实经常一起工作,但负责的环节不同。
Function Calling 主要解决:
模型如何表达“我想调用这个函数”。
例如 Host 给模型提供:
get_order(order_id)
search_tickets(status)
模型根据当前上下文返回:
调用 get_order
order_id = A10248
这属于模型与 Host 之间的工具调用机制。
MCP 解决的是另一层问题:
Host 去哪里发现这些工具,又怎样以统一方式调用它们。
完整关系更接近:
MCP Server
│
│ tools/list
▼
MCP Client
│
│ Tool definitions
▼
Host
│
▼
LLM
│
│ 选择 get_order
▼
Host
│
▼
MCP Client
│
│ tools/call
▼
MCP Server
因此在实际 Agent 中,两者经常共同出现。
MCP 把 Tool 定义交给 Host,Host 再按照具体模型供应商支持的 Tool Calling / Function Calling 格式提供给模型。
模型决定要调用哪个 Tool。
Host 再通过 MCP Client 完成真实调用。
十一、MCP 和 API 有什么区别
MCP 出现以后,还有一种说法是:
有了 MCP,以后是不是不需要 API 了?
现实恰恰相反。
绝大多数 MCP Server 背后仍然依赖 API。
例如:
Agent
│
│ MCP
▼
Order MCP Server
│
│ REST API
▼
Order Service
订单系统已经有稳定 API,就没有必要为了 MCP 重写订单系统。
我们只需要在 MCP Server 中调用原来的 API:
@mcp.tool()
def get_order(order_id: str):
return order_api.get_order(order_id)
API 主要解决系统与系统之间的接口问题。
MCP 在此基础上增加了一套面向 AI 应用的能力描述、发现和调用方式。
所以更准确的关系是:
MCP
│
▼
API / SDK / Database / File System
MCP 经常建立在现有基础设施之上。
十二、MCP 和 RAG 有什么关系
RAG 也是 Agent 开发中经常和 MCP 一起出现的概念。
例如公司有十万份内部文档。
用户问:
我们企业版退款有什么特殊规则?
RAG 系统可能执行:
Question
│
▼
Retrieval
│
▼
Relevant Documents
│
▼
LLM
它解决的是:
怎样从大量知识中找到与当前问题相关的内容。
MCP 关注的是:
AI 应用怎样连接并使用这种能力。
因此完全可以构建:
Agent
│
│ MCP
▼
Knowledge MCP Server
│
▼
RAG Service
│
├── Embedding
├── Vector Database
└── Reranker
然后向 Agent 暴露:
search_knowledge(query)
RAG 成为 Tool 背后的实现。
也可以把确定的文档通过 Resource 暴露:
kb://policies/refund
MCP 和 RAG解决的是不同层次的问题,因此经常组合使用。
十三、本地 MCP 和远程 MCP
MCP Server 并不一定部署在服务器上。
一个常见场景是本地进程:
AI Application
│
│ stdio
▼
Local MCP Server
│
▼
Local Files / Git / CLI
这类方式适合访问本地文件、开发工具或者操作系统能力。
另一种是远程服务:
AI Application
│
│ HTTP
▼
Remote MCP Server
│
▼
Business Service
例如:
CRM
订单系统
企业知识库
数据平台
内部 SaaS
可以统一部署为 Remote MCP Server。
当前 SDK 支持 stdio、Streamable HTTP 等标准传输方式。
对于刚开始学习 MCP 的开发者,不需要马上深入这些协议细节。
先掌握:
本地能力 → stdio MCP Server
远程业务能力 → HTTP MCP Server
已足够可以设计实际系统。
十四、什么时候值得使用 MCP
MCP 很有价值,但它并不意味着每个 Agent 都需要增加一个 MCP Server。
例如只有一个简单应用,而且只有两个内部函数:
search_database()
calculate_price()
这些函数只服务当前 Agent,也没有复用需求。
直接通过模型的 Tool Calling 使用它们,结构通常更简单。
当下面的情况出现时,MCP 的价值会明显增加:
同一种能力开始被多个 Agent 或 AI 应用共享;外部系统越来越多;工具需要独立开发和部署;希望模型供应商与业务能力之间保持较弱耦合;需要把内部系统提供给不同 AI Client;或者准备把某项能力作为标准化 Agent 接口提供给其他团队。
所以判断是否需要 MCP 时,可以思考一个很实际的问题:
我是在给当前 Agent 写一个函数,还是在提供一种可以被多个 AI 应用使用的能力?
如果答案接近后者,MCP 通常会更加合适。
十五、MCP 的真正难点往往不是写 Tool
写一个 Tool 很简单:
@mcp.tool()
def get_order(order_id: str):
...
真正进入生产环境以后,问题会很快转向:
谁可以调用这个 Tool?
模型能否直接执行删除操作?
不同用户看到的数据是否应该不同?
API Token 放在哪里?
读取到恶意内容怎么办?
敏感操作是否需要用户确认?
这些问题比装饰器本身重要得多。
例如:
get_order()
通常只是读取数据。
而:
refund_order()
delete_customer()
send_email()
已经会修改外部世界。
这类 Tool 应该设置更严格的权限边界,很多场景还需要用户确认。
同时,MCP Server 的凭据应该保留在 Server 侧:
Agent
│
│ MCP
▼
MCP Server
│
│ API Token
▼
Business API
模型不需要知道真正的数据库密码或者业务系统 Token。
还要考虑 Prompt Injection。
Agent 从工单、网页、邮件或者文档中读取的内容都属于外部数据,其中可能包含恶意指令。
MCP 解决的是连接标准,并不会自动让模型免疫 Prompt Injection。
官方 MCP 资料也明确提醒,Tool annotations 等元数据只能给 Host 提供风险信息,真正的安全边界仍需要权限控制、网络限制、沙箱和人工确认等机制落实。
因此,生产 MCP Server 至少应把“最小权限”“凭据隔离”“敏感操作确认”和“不可信数据边界”作为基础设计。
十六、重新理解 MCP
回到文章开始的客户支持 Agent。
用户只说了一句话:
帮我整理今天收到的客户问题,结合订单状态和产品知识库,找出最需要优先处理的三个问题,给出处理建议,并为负责人创建跟进任务。
真正执行时可能经过:
用户
│
▼
Agent
│
├── search_tickets()
│
├── get_order()
│
├── kb://policies/refund
│
└── create_followup_task()
│
▼
最终结果
模型负责理解任务、判断下一步和生成结果。
Host 负责运行 Agent、管理上下文和安全策略。
MCP Client 负责协议通信。
MCP Server 负责向 AI 应用暴露外部数据和能力。
底层仍然可以是:
REST API
Database
File System
SDK
Search Engine
RAG
Internal Service
MCP 的意义就在这些层之间建立了一个统一边界。
当 Agent 只调用一两个内部函数时,这层协议可能没有必要。
当系统逐渐需要连接更多工具、更多数据源,并且这些能力需要被多个 AI 应用重复使用时,MCP 的价值才会真正显现出来。
理解到这里,MCP 就不再只是:
@mcp.tool()
这样的几个装饰器。
它解决的是一个更加基础的工程问题:
当 Agent 开始真正连接外部世界,我们应该用什么方式定义、发现和调用这些能力。
社区讨论
参与讨论
有问题或想法?欢迎继续讨论。