Agent 能正常返回结果,只能说明这一次调用跑完了。
在实际的 Agent 开发中,我们还会遇到另一些问题:回答为什么错了?为什么没有调用应该调用的 Tool?一次请求为什么跑了十几秒?Token 为什么越来越高?同样的输入,昨天正常,今天换了 Prompt 之后为什么开始不稳定?
这些问题只看最终输出很难回答。Agent 中间经过了哪些模型调用、Tool Call 和状态变化,需要把完整执行过程记录下来。
LangSmith 提供的 Tracing,就是用来查看这些过程的。LangChain 创建的 Agent 可以直接接入 LangSmith,记录模型调用、Tool 调用、输入输出、Token、耗时和异常等信息。
一、Agent调试困境
普通服务出现错误时,我们习惯看日志和异常堆栈。
例如一个接口的执行过程可能很固定:
Request
↓
Service
↓
Database
↓
Response
如果这个过程出错了,只要知道请求参数,再结合日志,通常很快定位到问题在哪一层。
而 Agent 的执行路径则没有这么固定。
一个简单请求可能只调用一次模型,也可能是包含一次或多次工具的调用:
User
↓
Model
↓
Tool Call
↓
Tool
↓
Model
↓
Tool Call
↓
Tool
↓
Model
↓
Answer
Tool 是否调用、调用哪个 Tool、传入什么参数,以及拿到 Tool Result 后是否继续执行,都由模型根据当前上下文决定。
因此,当用户提出“Agent 执行结果或输出有问题”时,其实过于笼统。
可能是模型没有调用 Tool,也可能调用了错误的 Tool;可能 Tool 参数生成错了,也可能 Tool 返回的数据就有问题;甚至还有这种可能:Tool 明明已经返回正确数据,模型在最后整理答案时又说错了。
例如下面的 Agent:
用户:北京现在多少度?
Agent:北京现在 28℃
只看到这两行,我们甚至无法确定 28℃ 来自天气接口,还是模型根据已有知识自己回答的。
调试 Agent ,关键在于看清它的中间执行过程,而这正是 LangSmith 能帮我们做到的事。
二、Tracing执行链路
LangSmith 是一款用于追踪、调试和评估 LangChain 应用的可观测性平台。
在 LangSmith 中,一个执行单元称为 Run。
一次模型调用是 Run,一次 Tool 调用也是 Run,一段被追踪的自定义逻辑同样可以成为 Run。一次完整操作产生的多个 Run 会组成一个 Trace。
例如一次天气查询可能形成:
Agent Trace
│
├── Model Run
│
├── Tool Run: get_weather
│
└── Model Run
第一轮模型判断要不要查天气服务或 Tool,并生成 Tool Call;Tool Run 执行查询;第二轮模型读取 Tool Result,再组织最终答案。
如果有多轮对话,还可以进一步使用 Thread 把多次 Trace 关联起来。LangSmith 中,一轮用户交互对应一个 Trace,多轮会话可以通过 thread_id 组织成一个 Thread。
Run、Trace 和 Thread 三者的关系如下:
Run 一次具体执行
Trace 一轮请求的完整执行链
Thread 多轮对话中的多个 Trace
三、LangSmith接入
LangChain Agent 已经支持 LangSmith Tracing。最简单的方式是在环境变量中开启,不需要为了追踪单独改写 Agent 的执行逻辑。
export LANGSMITH_TRACING=true
export LANGSMITH_API_KEY=你的_LANGSMITH_API_KEY
export LANGSMITH_PROJECT=langchain-agent-demo
如果使用 .env 文件,也可以写成:
LANGSMITH_TRACING=true
LANGSMITH_API_KEY=你的_LANGSMITH_API_KEY
LANGSMITH_PROJECT=langchain-agent-demo
LANGSMITH_PROJECT 用来区分不同应用或环境产生的 Trace。没有指定时,Trace 会进入默认项目。
先看一个简单的天气 Agent:
from langchain.agents import create_agent
from langchain_openai import ChatOpenAI
from common import MODEL, API_KEY, BASE_URL
from dotenv import load_dotenv
load_dotenv(dotenv_path="./.env")
model = ChatOpenAI(model=MODEL, api_key=API_KEY, base_url=BASE_URL)
def get_weather(city: str) -> str:
"""查询指定城市的当前天气。"""
return f"{city}当前天气晴,气温 26℃"
agent = create_agent(
model=model,
tools=[get_weather],
system_prompt="你是一个天气助手,需要查询天气时使用工具。",
)
result = agent.invoke(
{
"messages": [
{
"role": "user",
"content": "北京现在天气怎么样?",
}
]
},
config={
"tags": ["weather-agent"],
"metadata": {
"environment": "development",
"version": "v1",
},
},
)
print(result["messages"][-1].content)
示例输出:
北京当前天气晴,气温 26℃。
上述代码中没有显式创建 Trace,也没有在 get_weather 里添加记录调用的日志。
但只要我们开启 LangSmith Tracing,LangChain 在执行 Agent 时产生的模型调用和 Tool 调用就会进入同一条 Trace。
打开 LangSmith,在相应的项目中,我们可以看到如下 Trace 内容:
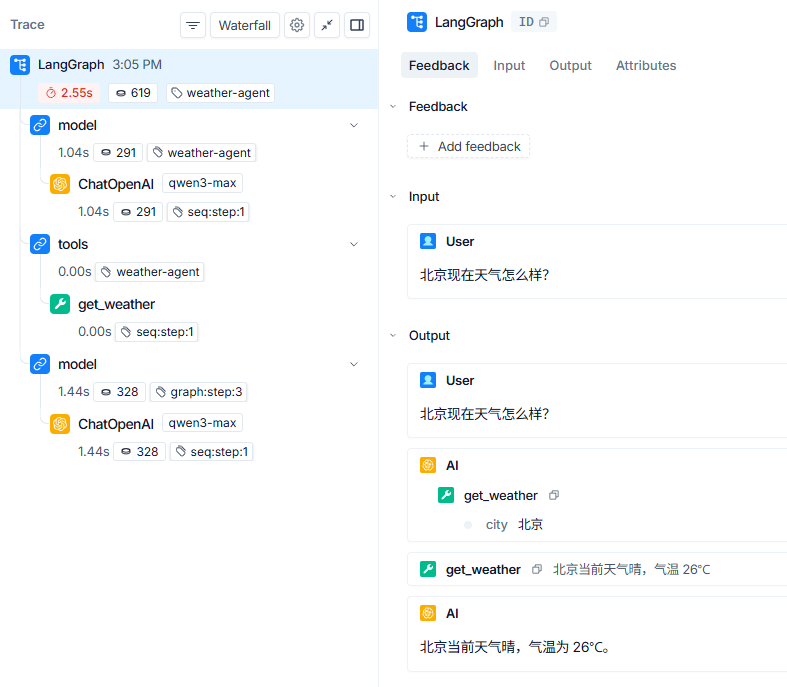 放大查看 ↗
实际项目中还可以通过 config 给一次调用附加 tags 和 metadata。
例如上面的配置:
config={
"tags": ["weather-agent"],
"metadata": {
"environment": "development",
"version": "v1",
},
}
它们不会改变 Agent 的行为,但后面排查线上问题时很有用。
例如某个版本发布以后错误率突然升高,可以直接筛选:
environment = production
version = v1
在筛选结果中再去看这一批 Trace,而不用从所有请求中逐条寻找。
四、Trace信息阅读
打开 Trace 后,不需要一开始就研究所有字段。
可以按照 Agent 实际执行顺序看:
用户输入
↓
第一次 Model
↓
Tool Call
↓
Tool Result
↓
第二次 Model
↓
最终回答
还是上面的天气 Agent。
第一次 Model Run 可以先看模型收到的 Messages,然后看它产生的 Tool Call:
{
"name": "get_weather",
"args": {
"city": "北京"
}
}
如果这里没有 get_weather,说明问题发生在 Tool 执行之前。应该检查 Prompt、Tool 描述以及当前上下文,而不是去调试天气接口。
如果 Tool Call 正确,再看 Tool Run:
{
"city": "北京",
"temperature": 26,
"condition": "晴"
}
假设 Tool Input 中的城市已经变成上海,那么错误来自模型生成参数的过程。
如果输入是北京,而 Tool Result 返回了错误温度,才需要去查 Tool 内部逻辑或下游 API。
还有一种情况:
Tool Result:26℃
最终回答:28℃
这时 Tool 没有问题,需要回到后面的 Model Run,看看模型实际收到了哪些消息,以及它怎样处理 Tool Result。
LangSmith 的 Details 视图可以查看具体 Run 的 Inputs、Outputs、Timing、Token、Error 和 Metadata。调试时顺着调用链定位,通常比同时盯着整段日志有效得多。
五、Token消耗变化
Token 很容易被简单理解成“用户问得越长,费用越高”。
然而,在 Agent 场景中,只看总 Token 还不够。
先从一次模型调用看。AIMessage 中可以包含 usage_metadata,其中包括 Input Token、Output Token 和 Total Token。是否能拿到这些数据取决于模型提供方。
from langchain_openai import ChatOpenAI
model = ChatOpenAI(
model="gpt-5.5",
)
response = model.invoke(
"用一句话解释什么是 LangChain Agent"
)
print(response.usage_metadata)
不同模型和输入产生的数据会有所不同,下面为示例输出:
{
"input_tokens": 18,
"output_tokens": 42,
"total_tokens": 60,
}
usage_metadata 对应的是这一次 Model Run 的 Token 使用情况。
注意,上例是直接调用模型,在 Agent 中,还需要把视角扩大到整个 Trace。一次 Agent 执行可能连续调用模型多次,每一次都会产生自己的 Token 消耗。例如:
Model #1 1200 input tokens
Tool
Model #2 1800 input tokens
Tool
Model #3 2400 input tokens
第三次调用的 Input Token 往往比第一次多,因为前面的 AI Message、Tool Call 和 Tool Result 已经进入了后续上下文。
所以一轮 Agent 的成本不能只看最后一条 AIMessage。更有意义的是看整个 Trace 中调用了几次模型,以及每一次 Model Run 消耗了多少 Token。
多轮会话还会出现另一层增长。
假设 Agent 保留历史消息:
第 1 轮:
System + User1
第 2 轮:
System + User1 + AI1 + User2
第 3 轮:
System + User1 + AI1 + User2 + AI2 + User3
随着轮数增加,发送给模型的历史消息通常也在增加。对话历史越长,Input Token、响应时间和成本都可能继续上升。因此,长对话会带来更高成本、更慢响应,还可能因为过多旧信息影响模型表现。
如果每轮中还包含多次 Tool Call,增长会更加明显。尤其是搜索、RAG、数据库查询这一类 Tool,如果直接把大段原始结果塞回上下文,后续每一次模型调用都可能重复包含这部分 Token。
实际排查 Token,我们应当注意观察以下三点:
- 一轮 Agent 调用了多少次模型;
- 每次 Model Run 的 Input Token 是否持续变大;
- Tool Result 和历史 Messages 中有没有明显过长的内容。
如果增长来自历史会话,可以考虑 Trim、删除旧消息或者对早期内容做摘要。LangChain 已经提供了消息裁剪和 SummarizationMiddleware 中间件。
六、Latency耗时分布
Latency(延迟)指的是从请求发出到收到响应所经过的时间。在 Agent 的执行链中,延迟也应该按执行链逐步分析,而不能只看总耗时——因为不同环节的耗时分布,往往能更精准地暴露性能瓶颈所在。
假设一个 Agent 从收到请求到最终返回用了 8 秒:
Agent 8.0s
├── Model 1.4s
├── search_tool 4.8s
└── Model 1.6s
只知道“接口耗时 8 秒”,很容易把注意力放到模型上。
Trace 展开以后会发现,真正慢的是 search_tool。
这时继续压缩 Prompt,或者为了降低几十毫秒去更换模型,意义都不大。更应该检查 Tool 调用的网络请求、数据库查询、Timeout,以及有没有并行执行的空间。
反过来,如果 Tool 只有几百毫秒,而模型连续调用了五六次,那么问题可能是 Agent 执行轮数过多。
LangSmith 中也可以统计 Trace 和 LLM Call 的 Latency,可以看到 Tool Run 的调用次数、错误率和耗时。
七、Tool Call调试
Agent 中比较费时间的问题,经常发生在工具的调用上。
要对 Tool 的调用进行调试,可先检查工具的定义(Tool Definition),再检查调用,最后再检查结果。
模型决定是否调用 Tool,依赖 Tool 的定义(包含:名称、描述、输入 Schema)和当前上下文。如果两个 Tool 功能接近,描述又写得很模糊,模型选错并不奇怪。
接着看 Tool Call。Tool 选对了,不代表参数一定对。很多“数据库查不到数据”的问题,继续往前追会发现,模型提取的订单号已经错了。
{
"name": "search_order",
"args": {
"order_id": "ORDER-100001"
}
}
然后再看 Tool 的实际执行过程,重点检查是否存在超时、第三方 API 异常、数据库错误、Retry 失败,以及 Tool 自身的异常处理问题。
最后还要看 Tool Result,是否为预期执行结果。
总之,对 Tool 的调试不应停留在“有没有异常”。还要看 Tool 选得对不对、参数对不对、返回内容是否适合继续交给模型。
总结
LangSmith 的价值,在于把 Agent 原本不容易看到的执行过程展开出来。
通过 Tracing,可以从一次 Trace 中查看模型调用、Tool Call、Tool Result、Token、Latency 和异常位置。当结果不对时,可以顺着 Run 找到信息从哪一步开始出错;当响应变慢或成本升高时,也可以继续定位是模型调用次数、上下文增长,还是某个 Tool 占用了更多时间。
需要注意的是,Trace 正常并不代表业务结果一定正确。可观察性解决的是“看清执行过程”,真正进入生产环境后,还需要结合评估、业务指标和用户反馈判断 Agent 的实际表现。
对于包含多轮对话、多个 Tool 和外部服务的 Agent,尽早接入 Tracing,后续调试会轻松很多。
社区讨论
参与讨论
有问题或想法?欢迎继续讨论。